6、RabbitMQ消息可靠性与插件机制以及其它常见问题
1、消息的可靠性
消息的主要流转过程经过生产者、broker以及消费者,所以MQ消息的可靠性环节主要体现在这三个阶段
1.1、生产者
生产者要保证消息成功投递到了MQ,主要有事务消息和确认机制两种方式
1.1.1、事务消息
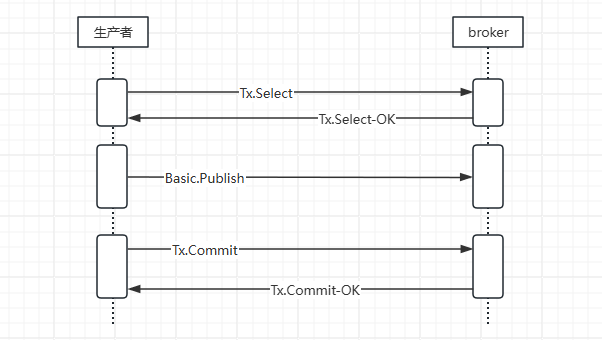
rabbitmq的事务消息原理如上图所示:
- 生产者首先发送一个tx.select请求,提醒broker接下来要发送一个事务消息
- broker接收到这个请求后回应一个tx.select-ok
- 生产者收到broker的成功响应后,开始发送事务消息
- 生产者消息发送完成之后,发送一个tx.commit请求到broker,提醒broker事务消息已经发送完成
- broker接收到事务消息发送完成的请求之后给生产者回应一个tx.commit-ok的响应。事务消息流程完成
对应发送事务消息的代码我们可以这么写:
try {
	channel.txSelect();
    // 发送消息
    // String exchange, String routingKey, BasicProperties props, byte[] body
    channel.basicPublish("", "QUEUE_NAME", null, (msg).getBytes());
    channel.txCommit();
    System.out.println("消息发送成功");
} catch (Exception e) {
    channel.txRollback();
    System.out.println("消息已经回滚");
}
虽然rabbitmq提供了这种发送事务消息的方式,但是毕竟要多发送几次额外的消息“无关”请求消耗一定的性能,所以在实际开发过程中并不推荐,如果要保证一个批次的消息同时成功或者失败,我们推荐使用rabbitmq的确认机制来实现
1.1.2、确认机制
confirm模式和事务模式差不多,区别在于tx模式下生产者发送消息后需要等待调用tx.commit并且等到服务端返回Commit-OK之后才算完成一次消息生产;而在confirm模式下,生产者每次发送消息服务端都会返回一个相应结果,标识此次消息发送请求服务端是否接收成功。
rabbitmq的confirm机制提供了单条确认模式、多条批量确认模式以及异步确认模式,具体可以参考《一篇文章弄清楚常见消息中间件的事务消息》介绍事务消息的这篇文章。
比如在SpringBoot环境下,可以像这样设置异步监听:
rabbitTemplate.setConfirmCallback(new RabbitTemplate.ConfirmCallback() {
    @Override
    public void confirm(CorrelationData correlationData, boolean ack, String cause){
        if (!ack) {
        	System.out.println("发送消息失败:" + cause);
        	throw new RuntimeException("发送异常:" + cause);
        }
    }
});
1.1.3、可靠性发送
rabbitmq提供了一个消息的可靠性发送机制,可以根据不同的业务场景进行选择
- 最多一次(at most once)
最多一次,消息可能会丢失,但绝不会重复
- 最少一次
最少一次,消息不会丢失,但是可能会出现重复传输。要实现最少一次需要考虑以下两点:
① 消息生产者需要开启事务机制,或者使用confirm模式,以确保消息可以可靠地传输到broker上
② 生产者需要配合mandatory参数或者备份交换器来确保消息能够从交换器路由到队列,进而保证消息被保存下来不会被丢失
实际开发中可以参考流程如下:
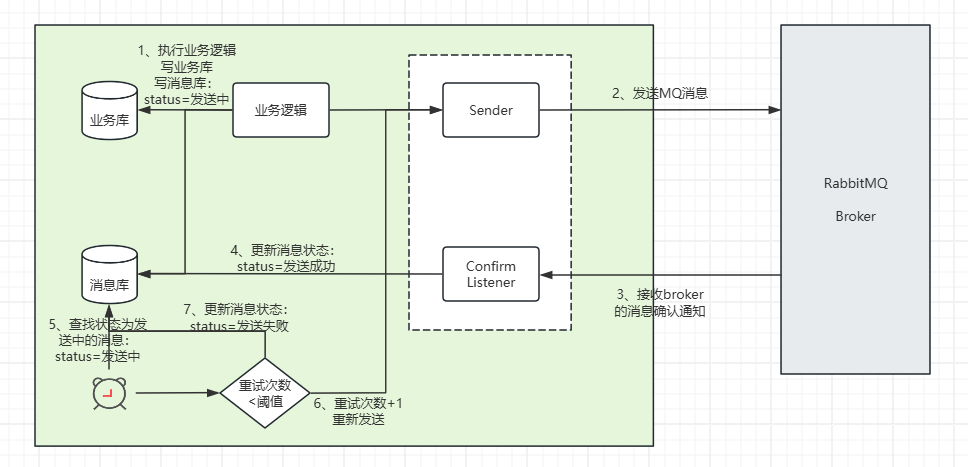
- 刚好一次(RabbitMQ不支持)
恰好一次,每条消息都会被传输一次且仅会传输一次
1.2、broker
消息被成功发送到了broker后,如果rabbitmq没有一个可靠的存储机制,消息也有可能出现丢失。
1.2.1、持久化机制
rabbitmq的持久化主要体现在vhost、交换机以及队列等的持久化。如果这些对象不设置为持久化,那么在broker重启之后可能会丢失。所以一般正式的应用中都会设置成持久化的。
1.2.2、内存可磁盘管理机制
rabbitmq为了保证数据的可靠,设计了一套内存和磁盘的管理机制,如果内存或者磁盘剩余空间超过一定的阈值,系统就会停止接收生产者发送过来的消息,并且会停止与客户端的心跳检测。并且这个阈值都是可以通过rabbitmqctl命令或者配置文件进行配置的,两者的方式不同点在于通过命令行修改的参数属于临时的,broker重启之后会失效,修改配置文件的方式是持久化的,不会随着broker节点的重启而失效。
与此同时,rabbitmq还有一套换页机制。简单地说就是在内存即将达到设置的阈值(换页阈值同样也可以配置)的时候,会触发rabbitmq的换页,broker会将队列中的消息持久化到磁盘,从而进一步分析是否可以释放一部分内存。
换页机制是不区分持久化消息和非持久化消息的。
1.3、消费者
默认情况下,在消费端消息的接收确认机制是自动ack的,也就是说消费者在接收到消息之后就自动给broker发送了一个消息送达的指令,不管后续的程序执行结果如何。这样一来,如果后续程序消息的消费业务逻辑失败异常,这条消息就无法再进行消费了,也就是会出现消息丢失的情况。
要解决这个问题,一般我们会采用手动ack的模式。即在开启手动ack之后消费者并不会自动给broker发送消息确认通知,我们可以在程序正确执行后再进行手动ack,而这个过程我们完全是可以主动控制的,比如:
@RabbitListener(queues = "QUEUE_NAME", ackMode = "MANUAL")
public void onMessage(Message message, Channel channel) throws IOException {
    String body = new String(message.getBody());
    try{
        // TODO 执行业务逻辑
        // 手动ack
        channel.basicAck(message.getMessageProperties().getDeliveryTag(), false);
    }catch (Exception e){
        // 手动拒绝ack
        channel.basicNack(message.getMessageProperties().getDeliveryTag(), false, true);
    }
}
注意这是在SpringBoot环境下的一个例子,其中ackMode包含三个值:
- NONE:broker自动确认,只要消息正确送达到消费端,broker就会进行ack并将消息删除
- MANUAL:需要完全手动进行ack或者nack
- AUTO:程序自动进行ack,如果方法正常执行结束没有抛出异常,则自动调用
basicAck,否则就自动调用basicNack(默认会自动重新入队,也可以配置)
要注意none和auto的区别
2、插件
RabbitMQ支持多种插件,通过插件可以扩展多种核心的功能:支持多种协议、系统状态监控、其它AMQP 0-9-1交换类型、节点联合等,rabbitmq官方提供的插件可以通过命令rabbitmq-plugins list直接查看:
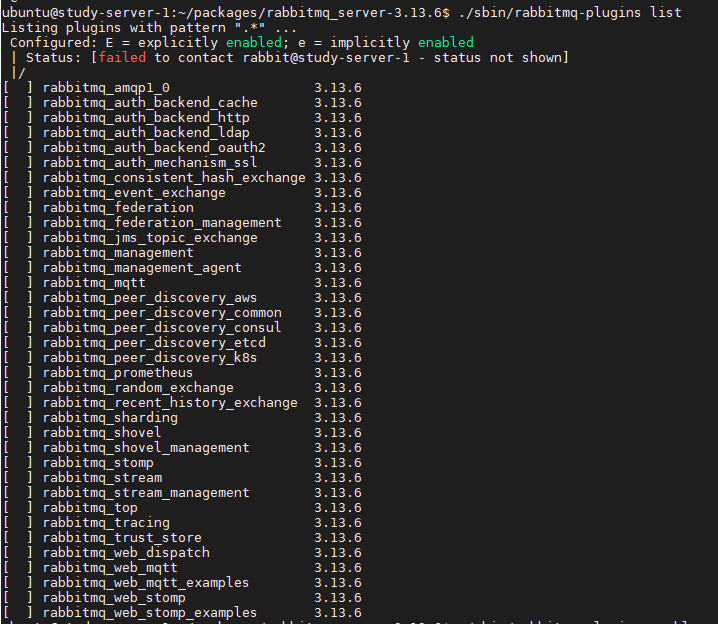
2.1、常用插件
- rabbitmq_auth_mechanism_ssl
身份验证插件,允许rabbitmq客户端使用x509heTLS(PKI)证书进行身份验证
- rabbitmq_event_change
事件分发插件,使客户端可以接收到broker上的queue.deleted、exchange.created、bingding.created等事件
- rabbitmq_management
基于web界面的管理和监控插件
- rabbitmq_management_agent
启用rabbitmq_management插件的时候会自动启动该插件,用户查看和管理集群中的节点
- rabbitmq_mqtt
mqtt插件,使rabbitmq支持mqtt协议
- rabbitmq_web_mqtt
使rabbitmq支持通过websocket订阅消息,基于mqtt协议传输
- rabbitmq_delayed_message_exchange
延迟消息插件,安装并启用该插件后,我们在发送消息的时候可以指定延迟发送的时间
官方要想启用直接通过命令rabbitmq-plugins enable xxx启用,而非官方提供的插件需要下载下来后放到plugins目录下后手动安装
3、常见问题
3.1、消息的可靠性
见上文
3.2、消息的幂等性
消息的幂等性是指在分布式环境下要保证消息不能重复消费,这个情况和接口的幂等性类似,解决的方案有很多,比如给每条消息指定一个全局唯一ID,在业务层面利用数据库的唯一性约束或者乐观锁等方式保证一条消息只允许一次消费
3.3、顺序消费
RabbitMQ默认不保证顺序:一个队列多个消费者并发抢消息时,不同消费者处理速度不同,后发送的消息可能先处理完成,最终导致乱序。对于有顺序要求的场景(比如订单的创建→支付→发货流程,乱序会导致业务出错),需要额外保证顺序。
要保障消息的顺序消费问题,可以从几个方面去考虑:
① 按照业务维度去考量,按业务唯一标识(如订单号)做哈希路由,将同一个业务的消息发送到同一个队列,生产推荐
② 单队列单消费者场景,即将所有消息都发送到一个队列,并且只有一个消费者单线程地对这个队列进行消费,利用的是队列本身的顺序性,不过一般不会用
③ 消费端在业务层面解决,比如先在本地对消息的顺序进行排序,然后再进行处理。不推荐,除了要手动ack还需要本地维护一套业务消息的顺序
3.4、消息积压
一般生产环境都会有相应的监控预警方案,如果rabbitmq出现了消息积压触发了告警,我们需要从几个方面来解决
3.4.1、紧急处理,优先业务恢复
线上出现故障,第一要考虑的是业务恢复
① 先定位核心问题
先通过监控确认积压原因:是消费者宕机、消费能力不足、流量突增、还是节点磁盘满/网络故障、ACK机制卡住导致的?
- 如果是消费者宕机/断连:第一时间恢复消费者实例,配置自动拉起机制,优先恢复消费。
- 如果是节点磁盘满:先清理冗余日志,紧急扩容磁盘,或将队列迁移到空闲节点解决存储问题。
② 提升消费速度快速消化积压 如果是消费能力跟不上生产,紧急水平扩容消费者实例:同一个队列的多个消费者是竞争消费模式,加实例可直接提升消费吞吐量。
③ 超大积压的紧急分流方案
如果积压量已经达到千万/亿级,扩容也无法快速消化,可做临时队列分流:
新建临时队列,修改原交换机的路由规则,把新消息路由到新队列,原队列只保留积压消息,然后启动多组消费者慢慢消费原队列的积压,不影响新消息的正常处理,快速恢复业务可用性。
④ 非核心消息的快速处理 如果是日志、统计类非核心消息,业务允许丢消息的情况下,可直接执行purge queue清空队列,快速恢复业务,后续再补数据即可。
3.4.2、根因定位与修复
紧急恢复后,排查积压原因针对性修复,常见问题和对应方案:
① ACK机制异常导致积压 问题:使用手动ACK时,消费异常没返回ACK,导致消息一直驻留队列不删除;或者prefetch预取数设置过大,一个消费者抢占了大量消息没处理,其他消费者空闲。 修复:完善异常捕获,无论消费成功失败都要返回ACK,消费失败的消息转发到死信队列;将prefetch调整为合理值(一般10~100,根据消费耗时调整),避免分配不均。
② 消费逻辑性能太差 问题:消费逻辑串行执行慢IO/DB操作、调用慢下游接口,导致单条消费耗时极高,整体吞吐量上不去。 修复:消费逻辑轻量化,将重操作异步化,快速返回ACK;用批量操作替代单条操作,开启RabbitMQ批量消费提升吞吐;给慢依赖配置降级熔断,不要让下游故障卡住整个消费流程。
③ 消费失败重复阻塞队列 问题:没有配置死信队列,消费失败的消息一直无限重试,占着队列资源导致正常消息堵。 修复:配置死信队列+最大重试次数,消费失败N次后自动转发到死信队列,后续人工处理,不影响正常消费。
④ 流量突增超过承载 问题:活动大促等场景突发流量洪峰,生产速度远超过消费峰值。 修复:生产者侧做限流削峰,上游拦截超量请求,或把请求先缓存到Redis慢慢转发MQ;拆分大队列,按照业务维度/路由键把大队列拆成多个小队列,每个队列单独消费,提升整体并发能力。
3.5.3、长期优化预防积压
① 完善监控告警:对队列堆积量、消费者在线数、消费时延、TPS配置多级告警,提前发现问题,不要等到积压严重才处理。
② 做好容量规划:提前压测评估峰值流量下的消费能力,大促活动前提前扩容消费者。
③ 架构优化:核心业务拆分队列,避免单队列过大;提前做好消费幂等,扩容扩容时不怕重复消费;合理配置镜像集群高可用,避免节点故障导致消费中断。
④ 定期故障演练,模拟积压场景,验证扩容、迁移流程的可用性,出问题时可快速响应。
3.5、如何利用MQ解决订单超时关闭
- 死信队列
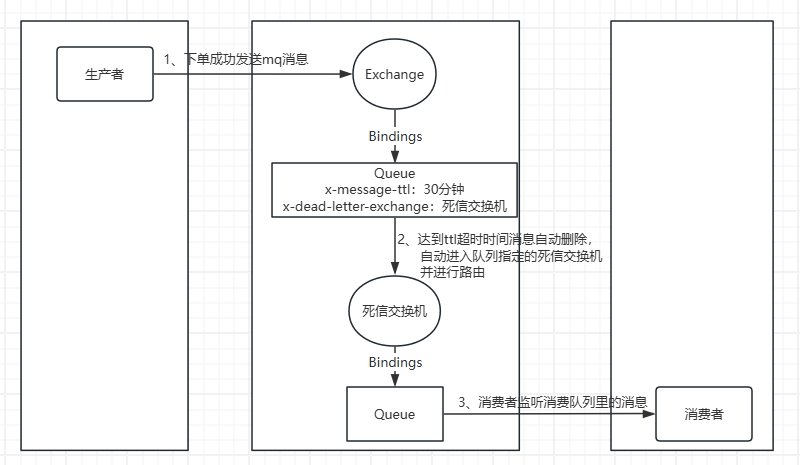
给一个队列设置一个消息自动删除的时间(message ttl),并且指定一个死信交换机(dead letter exchange),这样路由到这个队列的消息就会在对应的时间从该队列中删除,并进入到对应的死信交换机并进行对应的路由投递。如果这个死信交换机正确绑定了某个队列,那么这意味着这条消息在发出后经过ttl对应的事件进入到死信交换机绑定的这个队列上。业务上只需要监听这个队列即可在ttl间隔时间后接收到这条消息,然后检查订单状态并进行相应的处理即可
- 延迟消息
rabbitmq官方设计了一个延迟消息的插件rabbitmq_delayed_message_exchange,安装了这个插件之后可以在发送消息的时候指定一个延迟时间的参数,消息会在这个时间之后进行投递,比如设置的延迟时间是30分钟,那么正常情况下消费者会在30分钟后接收到这条消息
3.6、分布式事务
我们知道,kafka、rabbitmq和rabbitmq都有对事务消息的支持,在实际开发中事务是一个绕不开的话题,在当前分布式微服务主流架构场景下,MQ也经常作为分布式事务的一个常见方案,核心思想是在消息可靠性的基础上结合最终一致性。相比强一致性协议,在一定程度上可以有效提升系统的吞吐量和并发能力
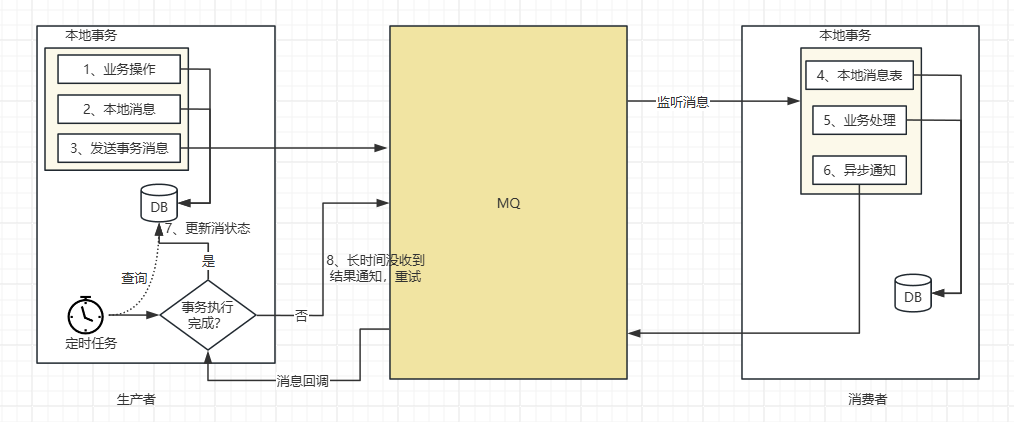
简要流程如下:
① 生产者开启本地事务,进行业务操作
② 记录本地事务消息日志
③ 发送事务消息
④ 消费者监听消息,接收到生产者发送的事务消息,查询本地事务消息表检查事务状态,并做好幂等性控制(如果已经处理过,则不做后续处理)
⑤ 对消息进行消费并执行相应的业务逻辑
⑥ 异步通知(生产者)执行结果
⑦ 生产者接收到异步回调消息,如果事务已经执行完成,则更新本地事务消息表
⑧ 定时任务定时扫描本地事务消息表,对超过一定时间没有收到结果回调的消息进行重试,达到超过阈值可以判定事务失败进行回滚